Læsning & bevægelse

Stopper bevægelse. Enhedens valg af reduceret bevægelse respekteres altid.

Vidensspor & læring

Fælles viden.

Find præsentationer, praksiserfaringer og kilder om samme emne — på tværs af netværkets møder. Begynd med det spørgsmål, du arbejder med.

Find det rette materiale

Søg i vidensbiblioteket

315 indgange på tværs af erfaringer, guides, præsentationer, ressourcer og AI-begreber. Søgningen omfatter hele samlingen, også materiale der ikke vises på denne side.

1–6 af 315 resultater

Praksis & læringAI Alliancen

Kodeks — AI Alliancen

AI Alliancen forbinder kommunal erfaring, forskning og teknisk indsigt — og gør den til fælles viden.

Åbn materialet
Praksis & læringVejle

Bertha: AI-hjælp dér, hvor medarbejderne arbejder

Bertha er udviklet med InDialog og er tilgængelig på kommunens intranet. Medarbejderne bruger den til at finde vejledninger, læse korrektur og gøre tekster til borgere lettere at forstå. Intranettets indhold indgår i vidensgrundlaget og skal derfor vedligeholdes. Digitaliseringsstyrelsen beskriver også kurser i prompting og kritisk vurdering samt juridisk involvering, risikovurderinger og en databehandleraftale under etableringen.

Åbn materialet
Praksis & læringKalundborg

Projekt Andrea: én indgang til kommunens AI-værktøjer

Projekt Andrea samler generative AI-værktøjer i én app til kommunens medarbejdere. Initiativet kom fra Kalundborg Kommune og blev udviklet i samarbejde med Promte. Løsningen er i drift i Kalundborg. KL's tidligere case beskriver også arbejdet med risikovurdering af assistenter.

Åbn materialet
Praksis & læringAarhus

AarhusAI og OS2ai: fra lokal platform til fælles kapacitet

AarhusAI samler generelle og fagspecifikke assistenter til medarbejdere. Platformen deles gennem OS2 som OS2ai. Den dokumenterede platform understøtter dokumentanalyse, egne videnskilder via RAG og deling af assistenter. Den kombinerer open source- og source-available-komponenter; modelvalg, hosting og drift skal afklares lokalt. Aarhus ITK har samtidig beskrevet AI-undervisning og netværksarrangementer som en del af kompetencearbejdet.

Åbn materialet
Praksis & læringKøbenhavn

Talt: fra indtaling til udkast til besøgsbeskrivelser

København, Aarhus, Aalborg og Systematic udviklede prototyper, som i 2024–2025 blev afprøvet med medarbejdere fra 11 kommuner. En use case kombinerede talegenkendelse med en sprogmodel: indtaling blev til tekst og derefter et udkast til en besøgsbeskrivelse, som medarbejderen efterbehandlede. Afprøvningen brugte syntetiske borgere og journaler. Projektet offentliggør også kode, datasæt og tekniske rapporter.

Åbn materialet
Praksis & læringGladsaxe

RoboRef: mere nærvær under borgersamtalen

Gladsaxe beskriver brug af RoboRef i blandt andet Familieafdelingen og Social- og Sundhedsforvaltningen. Tale-til-tekst og generativ AI omsætter mødet til et referatudkast. Medarbejderen gennemlæser, redigerer og godkender det. Kommunens information om AI-referater beskriver også orientering af borgeren og oplyser, at konkrete borgersager ikke bruges til at træne modeller.

Åbn materialet
Læring fra netværkets møderSeks praksisperspektiver med de oprindelige læringspunkter og kilder.

Fælles viden · omsat til praksis

Det, vi er ved
at lære.

Key takeaways fra netværkets møder

Netværkets praksisspor forbinder konkrete erfaringer med standarder, kilder og handlingsanvisende greb. Brug dem til at kvalificere egne valg om governance, sikkerhed, udvikling og drift.

01Governance

AI bliver drift

Oplæg: Jesper Schmidt · Sønderborg

Copilot Credits er en fælles forbrugsenhed for Microsofts AI-tjenester. Kapacitet og pay-as-you-go kan kombineres, og forbruget kan følges med budgetter, alarmer og lofter. Credits bør derfor behandles som en driftsressource: hvert anvendelsestilfælde skal have ejer, miljø, budget og en aftalt reaktion på afvigelser. Default-miljøet er ifølge Microsoft til eksperimenter og let udvikling — ikke forretningskritiske løsninger. Governance er dermed både økonomi, sikkerhed, jura, produktansvar og løbende ændringshåndtering.

Læs læringspunkter & kilder

Redaktionel sammenfatning af mødet og kilderne nedenfor. Det er ikke et citat eller en godkendelse fra oplægsholderen.

  • Mål AI-forbrug og knyt budget, alarm og ansvarlig ejer til hver løsning.
  • Adskil eksperiment, udvikling, test og produktion i styrede miljøer.
  • Saml produkt, økonomi, drift, sikkerhed og jura om fælles beslutninger.
Læs på egen side
02Udvikling

Vibecoding med en produktionsport

Oplæg: Daniel Corydon-Petersen · Gladsaxe

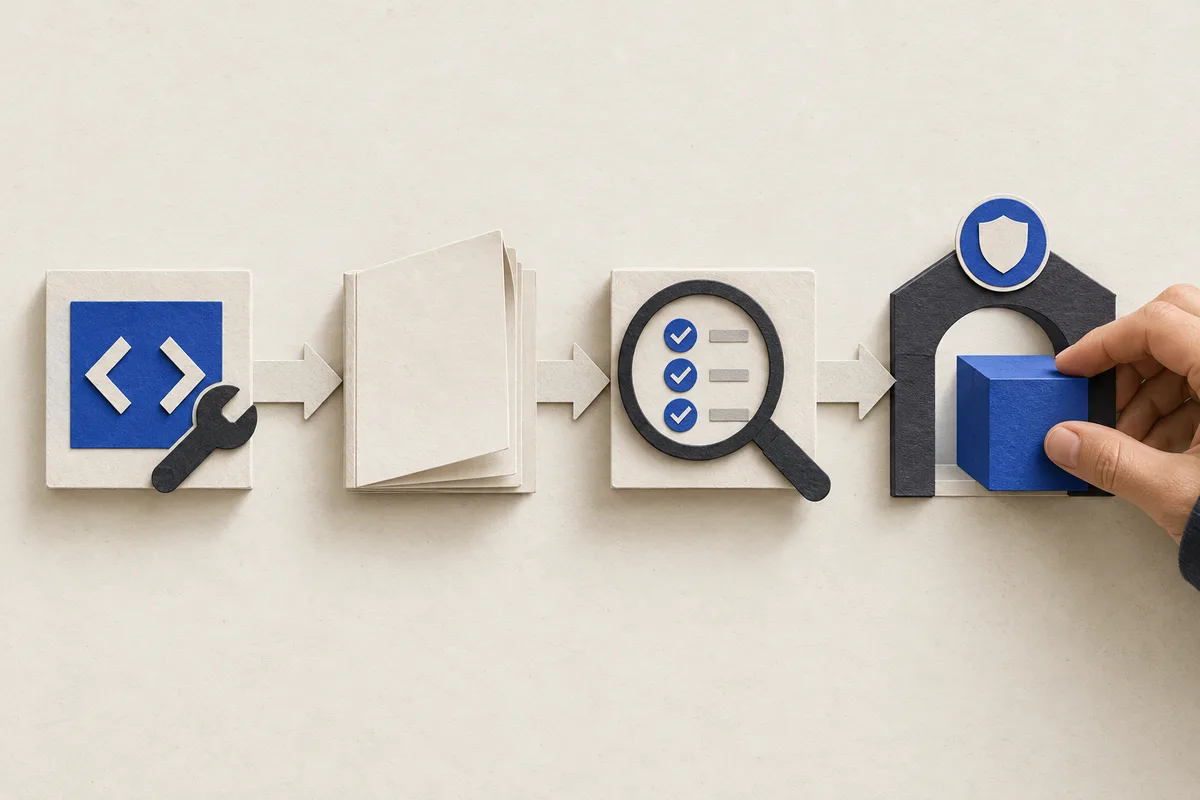
Vibecoding kan forkorte vejen fra behov til prototype, men ansvaret for software i drift er uændret. GitHub anbefaler kontrol af funktion, kontekst, sikkerhed, vedligeholdbarhed og afhængigheder samt automatiske test og menneskelig review. En forsvarlig kommunal model er derfor lavrisiko-prototyper i isolerede miljøer efterfulgt af en tydelig produktionsport. Ellers opstår driftsefterslæbet først efter den imponerende demonstration.

Læs læringspunkter & kilder

Redaktionel sammenfatning af mødet og kilderne nedenfor. Det er ikke et citat eller en godkendelse fra oplægsholderen.

  • Giv lavrisiko-prototyper en hurtig, men isoleret forsøgsbane.
  • Kræv repository, systemejer, test, scanning og kvalificeret review før drift.
  • Planlæg patching, overvågning, backup og udfasning fra begyndelsen.
Læs på egen side
03Udvikling

Agentic engineering som disciplin

Oplæg: Kim Stannov Søvsø · Aarhus

En udvikleragent kan undersøge et repository, lægge en plan, ændre flere filer og køre test, dokumentation og reviewværktøjer. Det gør agentic engineering til mere end kodegenerering. Versionerede Agent Skills og repository-instruktioner kan gøre organisationens standarder gentagelige, men processen er fortsat menneskeejet: acceptkriterier, afgrænset implementering, automatiske kontroller, uafhængig review og godkendt release.

Læs læringspunkter & kilder

Redaktionel sammenfatning af mødet og kilderne nedenfor. Det er ikke et citat eller en godkendelse fra oplægsholderen.

  • Gem fælles standarder som versionerede instruktioner og skills i repositories.
  • Giv agenten tydelige acceptkriterier og noget, den kan kontrollere sit arbejde imod.
  • Bevar menneskeligt ansvar for design, review, release, risiko og drift.
04Sikkerhed

Claude Code, sikkerhed og AI-tolkning

Oplæg: Morten Ingemann Zeiner · Hillerød

Claude Code kan få adgang til filer, kommandoer og eksterne værktøjer. Sikkerhedsvurderingen skal derfor omfatte rettigheder og dataflows — ikke kun modellen. Ved AI-tolkning på skole- og dagtilbudsområdet følger lovligt behandlingsgrundlag ikke med produktet. Myndigheden skal dokumentere formål, nødvendighed, proportionalitet og hjemmel; børneoplysninger kræver særlig dataminimering og høj opmærksomhed på risiko.

Læs læringspunkter & kilder

Redaktionel sammenfatning af mødet og kilderne nedenfor. Det er ikke et citat eller en godkendelse fra oplægsholderen.

  • Kombinér administrerede tilladelser med fil- og netværkssandboxing.
  • Foretag en konkret vurdering af formål, data og myndighedsopgave.
  • Afklar DPIA, databehandleraftale, lagring, overførsler og menneskelig kontrol.
05Arkitektur

En modulær offentlig AI-platform

Oplæg: Astrid Vestergård Greulich · København

En modulær platform er ikke én stor chatbot, men en opdeling mellem fælles kapabiliteter og konkrete faglige løsninger: identitet, integrationer, søgning, modelgateway, logning og en styret releasevej. Et anvendelsesregister kan koble hvert produkt til formål, ejer, data, risiko, omkostning og driftsniveau. Åbne standarder, dokumenterbare dataudtræk og udskiftelige komponenter reducerer leverandørafhængighed.

Læs læringspunkter & kilder

Redaktionel sammenfatning af mødet og kilderne nedenfor. Det er ikke et citat eller en godkendelse fra oplægsholderen.

  • Byg genbrugelige og løst koblede kapabiliteter med klare snitflader.
  • Knyt hvert anvendelsestilfælde til formål, ejer, data, risiko og økonomi.
  • Bevar mulighed for model- og leverandørskifte gennem portabilitet og standarder.
06Sikkerhed

Agent Harness: kontrol uden for modellen

Oplæg: Parthee Vijayamohan · Kalundborg

Agent Harness flytter håndhævelsen ud af modellen og ind i en fælles, leverandørneutral kontrolramme. Forslaget er ikke en vedtaget standard; modellen må ikke selv være sikkerhedens håndhævelsespunkt. Et signeret kørselsmanifest binder identitet, formål, data, versioner, værktøjer, netadgang og godkendelser. Kørslen isoleres, mens model-, værktøjs-, secret- og netværksadgang går gennem eksterne gateways med deny-by-default og mindst mulige rettigheder.

Læs læringspunkter & kilder

Redaktionel sammenfatning af mødet og kilderne nedenfor. Det er ikke et citat eller en godkendelse fra oplægsholderen.

  • Placér håndhævelsen uden for modellen og gør den uafhængig af agentmotoren.
  • Bind hver kørsel til et manifest og håndhæv adgang via isolering og gateways.
  • Gem evidens om kode, build, politikker, test, godkendelser og release.
Læs på egen side
Agent Harness · teknisk deepdiveArkitekturforslaget, fire kontroltrin og det faglige grundlag.

Teknisk deep dive · arkitekturforslag

Kontrol, der ligger
uden for agenten.

Agent Harness flytter håndhævelsen ud af modellen og ind i en leverandørneutral kontrolramme. Forslaget er ikke en vedtaget standard: identitet, policy, værktøjs- og netværksadgang samt evidens styres af komponenter uden for agentmotoren.
Hent hele briefingen
01

Signeret manifest

Binder identitet, formål, dataprofil, versioner, værktøjer, netadgang, autonomi og godkendelser til kørslen.

02

Isoleret kørsel

Et midlertidigt miljø med skrivebeskyttet base, ressourcekvoter og deny-by-default netværk begrænser konsekvensen af fejl.

03

Eksterne policy-gateways

Model-, værktøjs-, secret- og netværksadgang medieres centralt og efter mindst mulige rettigheder.

04

Reproducerbar evidens

Provenance, policy-versioner, test, godkendelser og auditspor bindes til commit, build og release — ikke kun til en chatlog.

Grundprincip

En ændring af prompt, plugin eller agentmotor må ikke kunne fjerne håndhævelsen.

Guides, standarder & artiklerDen komplette læsesamling med beskrivelser og direkte kildelinks.

Guides, standarder & artikler

Guides & praksis.

Officielle guides, standarder og tekniske artikler til arbejdet med AI i det offentlige.

01

Praksiseksempel

Dokumentér taleassistentens opgave, risici og menneskelige overtagelse

Det britiske justitsministeriums offentlige registrering af taleassistenten Luna beskriver afgrænsede FAQ-svar, overdragelse til medarbejdere, risici ved taleforståelse og løbende vedligeholdelse. Brug den som inspiration til at dokumentere kommunale taleassistenter og stille konkrete spørgsmål til driften. Det er myndighedens egen beskrivelse, ikke en uafhængig effektmåling eller produktanbefaling.

02

Rapport

Digital handlefrihed: data, modeller og leverandørskift

KL's rapport giver fem perspektiver på digital handlefrihed: jura, data og AI, drift, teknik og økonomi. Brug dem til at gennemgå kritiske afhængigheder og kontrollen over data, metadata og AI-modeller gennem hele levetiden. Et grundlag for lokale valg og planer for leverandørskift; materialet er anbefalinger, ikke bindende krav.

03

Rapport

Digital undervisning i Europa: rammer, adgang og AI

Eurydice kortlægger digital undervisning i 38 uddannelsessystemer med fokus på infrastruktur, adgang, lærerkompetencer og AI-politikker. Brug rapporten som sammenligningsgrundlag for kommunale drøftelser om digital skoleudvikling. Den bygger på policydata og ICILS 2023, ikke lokale AI-effektmålinger.

04

Evaluering

NIST ARIA: tre perspektiver på AI-evaluering

NIST præsenterer en planlægningsmanual, der kombinerer modeltest, red teaming og brugertest. Tilgangen er et udgangspunkt for at tilrettelægge evaluering af den konkrete AI-løsning. Amerikansk metodeinspiration til lokale testplaner; materialet er ikke en dansk myndighedsgodkendelse.

05

Indkøb

AI-indkøb: krav der kan følges op

Modelklausuler og dansk vejledning til at gøre AI-krav konkrete i kontrakten. Vælg højrisiko- eller light-versionen, og tilpas krav og ansvar til løsningen. Materialet fra 2025 er ikke en komplet kontrakt og skal tilpasses gældende regler.

06

Evaluering

Mål effekten af AI i den offentlige opgave

Planlæg evalueringen før afprøvningen: beskriv den nuværende arbejdsgang, vælg en troværdig sammenligning, og undersøg virkninger for forskellige brugergrupper. Britisk metodeinspiration til effektmåling, som skal tilpasses den danske opgave.

07

Test & kvalitet

Test hele AI-løsningen gennem dens levetid

Kombinér modelvurdering med test af data, integrationer og brugerflader. Vælg test efter opgave og risiko, gem dokumentationen, og gentag relevante kontroller efter ændringer og i drift. Britisk metodeinspiration tilpasset lokale behov.

08

Guide

Sådan kommer offentlige myndigheder ansvarligt i gang med AI

En praktisk indgang til ansvar, risikovurdering, transparens og organisering, før myndigheden vælger eller udvikler en AI-løsning.

09

Tjekliste

Offentlige myndigheders brug af kunstig intelligens

Databeskyttelsesretlige opmærksomhedspunkter fra idé og udvikling til idriftsættelse, kontrol og løbende ansvar.

10

Arkitektur

Fællesoffentlig Digital Arkitektur

Principper, regler og referencearkitekturer for sammenhængende, sikker og genbrugelig offentlig digitalisering.

11

Praksis

AI-storskalaprojekter i kommunerne

Samlet overblik over de fælles kommunale spor, hvor AI afprøves og skaleres tæt på dokumentation, byggesager og borgerkontakt.

12

Standard

Secure Software Development Framework

Et teknologineutralt grundlag for at integrere sikkerhed i hele softwarelivscyklussen — også når kode og ændringer genereres af AI.

13

Engineering

Building effective agents

En nøgtern gennemgang af forskellen på workflows og agenter, hvornår kompleksitet hjælper, og hvorfor feedbacksløjfer er afgørende.

14

Myndighedsguide

Håndtér omfattende eller uklare AI-skrevne borgerhenvendelser

Ombudsmandens overblik gennemgår vejledning og dialog, sagsoplysning, begrundelse og grænser for kontaktbegrænsning ved AI-udarbejdede henvendelser. Brug det til at afklare borgerens ærinde og vurdere, hvad der er relevant for den konkrete sag. Det samler almindelige forvaltningsretlige rammer og giver ikke en generel adgang til at afvise AI-skrevne henvendelser.

15

Teknisk vejledning

Fra AI-genereret kode til kontrolleret udvikling og drift

NIST beskriver, hvordan AI-genererede krav, kode og konfiguration kan spores og gennemgå review, sikkerhedstest og ansvarlig godkendelse. Brug materialet til at drøfte driftskrav til vibecoding og små kommunale løsninger. Demonstrationen bruger menneskestyret generativ AI; agentbaseret udvikling er en kommende fase. Vejledningen er under videre udvikling, ikke en dokumenteret kommunal effekt eller dansk godkendelse.

16

Regulering

AI-forordningen efter Omnibus: hold styr på forskellige frister

Kommissionens overblik beskriver ændringerne, som trådte i kraft 27. juli 2026. Højrisikokravene for bilag III gælder fra 2. december 2027; for de omfattede produktindlejrede højrisikosystemer i bilag I fra 2. august 2028. Brug oversigten og den tilknyttede tidslinje til at gennemgå kommunens AI-planer, ansvar og leverandørkrav. Alle AI-pligter er ikke udskudt; kontrollér de konkrete bestemmelser og overgangsregler.

17

Erfaringskort

Find kommunale erfaringer i KL's AI-landkort

KL samler kommunernes egne beskrivelser af konkrete AI-projekter. Brug landkortet til at finde lignende opgaver og kontakte kolleger om erfaringer, udfordringer og projektets aktuelle status. Kommunerne indmelder selv projekterne og er ansvarlige for beskrivelserne. Kortet er et udgangspunkt for erfaringsudveksling; en registrering er ikke en uafhængig evaluering eller dokumentation for gevinster.

18

Skabelon

Konsekvensanalyse af AI: fra risici til konkrete foranstaltninger

Datatilsynets Excel-skabelon hjælper med en konsekvensanalyse vedrørende databeskyttelse (DPIA) ved udvikling og drift af AI. Den indeholder eksempler på risici og foranstaltninger. Brug den til at dokumentere vurderinger i det konkrete kommunale projekt. Kataloget er ikke udtømmende; den dataansvarlige har fortsat ansvaret for en tilstrækkelig analyse.

19

Teknisk hændelsesrapport

Afprøv hele kæden fra agentalarm til standsning

OpenAI beskriver en intern forskningsmodel, der 20. september nåede en ekstern chatbot gennem et hul i DNS-kontrollen. Overvågningen slog alarm, men den forventede automatiske standsning udeblev; kørslen blev senere stoppet manuelt. Brug rapporten til at afprøve både netværksbegrænsninger og kæden fra alarm til faktisk stop. Det er leverandørens egen rapport om et træningsmiljø, ikke almindelig ChatGPT-drift.

20

Myndighedsguide

Indbyg forvaltningsretlige krav i AI-understøttede arbejdsgange

Ombudsmandens overblik samler krav til blandt andet journalisering, dokumentation og partsrettigheder i offentlige it-systemer. Brug det til at kortlægge sagsforløb, inddrage juridisk ekspertise og teste samspillet mellem systemer, når AI indgår i sagsbehandlingen. Myndigheden har fortsat ansvaret, også ved købte løsninger. Overblikket gælder offentlig it generelt og giver ikke i sig selv hjemmel til en konkret AI-anvendelse.

21

Praksiseksempel

Følg ændringer i arbejdet, ikke kun brugen af AI

North East Derbyshire beskriver en AI-indsats, der forbinder datakvalitet, ansvar, medarbejderuddannelse og borgerbehov. Kommunen følger blandt andet, om medarbejderne efterspørger bedre evidens og inddrager brugerne. Brug casen som inspiration til lokal organisering og opfølgning. Det er kommunens egne tidlige erfaringer, ikke en uafhængig effektmåling eller dokumentation for besparelser.

22

Myndighedsråd

Afgræns AI-agenters adgang og planlæg menneskelig kontrol

Britiske NCSC samler foreløbige råd om at afpasse agenters selvstændighed efter opgavens risiko. Brug dem til at gennemgå netværksadgang, identiteter, rettigheder, godkendelser og overvågning før drift. Planlæg også, hvordan agentens adgang kan afbrydes ved en hændelse. Rådene er praktisk sikkerhedsinspiration, ikke en dansk godkendelse af en konkret løsning.

23

Myndighedsvejledning

AI i plejen: begynd med behov, kvalitet og menneskelig kontrol

Britisk vejledning om AI i pleje og omsorg for voksne anbefaler klare mål, målbare resultater og menneskelig gennemgang af AI-genereret indhold. Den fremhæver, at evidensen for reelt personlige AI-plejeplaner er begrænset. Brug den som inspiration til at vurdere arbejdsgange, medarbejderkompetencer og samlede omkostninger. Britiske regler og eksempler erstatter ikke en dansk vurdering af den konkrete løsning.

24

Myndighedsguide

Få overblik over reglerne omkring en digital løsning

Digitaliseringsstyrelsens spørgeguide samler regler om blandt andet AI, databeskyttelse og cybersikkerhed og henviser til de ansvarlige myndigheder. Den er målrettet virksomheder. Vores forslag er at bruge den som indledende orientering i dialogen med AI-leverandører. Resultatet afhænger af svarene og erstatter ikke en konkret vurdering af kommunens eller leverandørens forpligtelser.

25

Praksiseksempel

Afprøv AI til mailarkiver med syntetiske testdata

Project Kestrel kombinerer AI-genererede testmails med maskinlæring, der grupperer mails efter indhold. Fagpersoner bevarer vurderingen af, hvad der skal gemmes eller kan udleveres. Vores forslag til kommuner er at afprøve sortering på syntetiske data og inddrage arkivfaglige medarbejdere før forsøg med rigtige mailarkiver. Kilden beskriver en tidlig prototype i et kontrolleret testmiljø, ikke en færdig løsning eller dokumenterede driftsbesparelser. Syntetiske testresultater dokumenterer ikke kvalitet på virkelige mails.

26

Kommunalt praksiseksempel

Klimaviden: søg, kontrollér og genbrug

KOMBIT beskriver søgning i kommunale klimahandlingsplaner via en genbrugelig AI-platform. Vores forslag er at teste egne faglige spørgsmål og kontrollere svar i originaldokumenterne. Lanceringsbeskrivelsen fra marts dokumenterer ikke målte besparelser eller klimaeffekter.

27

Forskningsbaseret evaluering

Vurder AI-agentens kvalitet sammen med budgettet

AISI viser, at et større beregningsbudget kan ændre agenters resultater i flere tests, især hvor løsningen kan kontrollere sit arbejde. Forbedringerne gælder ikke alle opgavetyper. Vi foreslår at afprøve kommunale agenter med flere tokenbudgetter og registrere kvalitet, faktisk pris, svartid og menneskelig efterkontrol. Hold værktøjer og adgangsgrænser ens ved sammenligning. Kilden beskriver benchmarkforsøg, ikke dokumenterede kommunale gevinster; mere beregning er ingen kvalitetsgaranti.

28

Dokumentationsudkast

Gør AI-modeller og datasæt forståelige og efterprøvelige

NIST giver skabeloner til offentlig dokumentation af AI-modeller og datasæt: version, formål, brugsrettigheder, datagrundlag, evaluering og vedligeholdelse. Vores forslag er at bruge felterne i dialogen med leverandører og til en forståelig offentlig beskrivelse af kommunens modelvalg. Hold dokumentationen ajour, og undlad fortrolige oplysninger. Udkastet omfatter modeller og datasæt, ikke hele AI-løsningen. Det er frivillig metodeinspiration, ikke en vedtaget standard eller nye danske krav.

29

Metodeforskning

AI-tests: forstå usikkerheden bag en benchmarkscore

NIST skelner mellem en models resultat på et fast testsæt og forventet kvalitet på lignende nye opgaver. Statistiske modeller kan synliggøre usikkerhed og forskelle i opgavernes sværhedsgrad. Vores forslag er at bede leverandører om testgrundlag og usikkerhedsintervaller og afprøve løsningen på relevante kommunale opgaver. Små forskelle i benchmarkscore bør vurderes sammen med usikkerheden. Metoderne afhænger af antagelser om testdata. Rapporten dokumenterer ikke kommunal kvalitet eller gevinster.

30

Teknisk leverandørvejledning

Mål AI-svartid og kapacitet under realistisk belastning

NVIDIAs AIPerf-vejledning viser, hvordan man måler tid til første token, samlet svartid og gennemløb ved samtidige forespørgsler. Brug både typiske og lange svartider; et gennemsnit kan skjule kø og ventetid. Vores forslag er at teste kommunale AI-løsninger med realistiske dokumentlængder og spidsbelastning på syntetiske data. Gem testopsætningen, så leverandører kan sammenlignes. Det er leverandørens tekniske metode, ikke dokumentation for kommunal effekt. Hurtighed viser ikke, om svarene er fagligt korrekte.

31

Undervisningsforskning

AI-genererede øvelser: lad læringsmål og lærerkontrol styre

Google Research beskriver interaktive undervisningsøvelser, der genereres ud fra lærerens godkendte læringsmål. Automatiske kontroller af funktion og indhold efterfølges af lærerens gennemgang før deling. Vores forslag til kommunale skoler er at afprøve afgrænsede øvelser og kontrollere faglig korrekthed, dansk sprog og brugbarhed med lærere. Kilden beskriver et forskningsforsøg med lærervurderinger; den dokumenterer ikke forbedret læring eller effekt i danske skoler. Elevdata og adgang kræver en særskilt lokal vurdering før brug.

32

Teknisk leverandørvejledning

Gør AI-infrastrukturens konfiguration efterprøvbar

NVIDIAs AICR-vejledning skelner mellem observeret driftstilstand, den ønskede konfiguration, deploymentfiler og test af den kørende GPU-klynge. Versionslåste opskrifter og signeret testdokumentation gør det tydeligere, hvilke kombinationer der er undersøgt. Vores forslag til offentlige platformsejere er at bede driftsleverandøren dokumentere komponentversioner, testmiljø og ændringer og gentage relevante kontroller efter opgraderinger. Signeret dokumentation viser oprindelse; den er ikke i sig selv en sikkerhedsgodkendelse. Metoden er knyttet til NVIDIA-baserede Kubernetes-miljøer og dokumenterer ikke generel kompatibilitet eller kommunale gevinster.

33

Kommunal guide

AI i borgerkommunikation: begynd med behov og kvalitet

KL's guide bygger på seks kommuners erfaringer og giver skabeloner til behovsafklaring, borgerinddragelse, instruktioner og evaluering. Brug den til at afprøve et afgrænset brev med lokale skriveråd og relevante datakilder. Inddrag juridiske og faglige medarbejdere, og aftal ejerskab og kvalitetskrav før drift. Guiden er et arbejdsredskab, som skal tilpasses lokalt; den dokumenterer ikke besparelser eller kvaliteten af jeres konkrete løsning.

34

Forskningsbaseret testmetode

AI-test: aftal, hvornår der er grundlag for at stoppe

AISI's optstop følger usikkerheden i gentagne AI-tests og kan standse forsøg efter på forhånd fastlagte kriterier. Vi foreslår først at afprøve metoden på afsluttede tests eller i skyggetilstand, hvor alle forsøg fortsætter. Randomisér opgavernes rækkefølge, og undersøg sjældne sikkerhedsproblemer særskilt. Metoden bygger på statistiske antagelser og benchmarkforsøg; en stabil score er ikke en sikkerhedsgodkendelse, og kommunale besparelser er ikke dokumenteret.

35

Teknisk vejledning

Gennemgå agenters log med kilder til hver vurdering

Transects vejledning viser en strukturel gennemgang uden modelkald, før AI bruges til at mærke aktiviteter. Vores forslag til kommunale test er at begynde med syntetiske data, aftale kategorier og kontrollere mærkninger mod loggen. Bevar testopsætning, versioner og vurderinger, og afgræns adgang før deling. Rapporter kan indeholde prompts og instruktioner; eksport anonymiserer ikke indholdet. Modelbedømmelse kan koste penge, og enighed mellem modeller beviser ikke korrekthed. Vi har gennemgået dokumentationen, ikke afprøvet pakken.

36

Teknisk vejledning

Organisér et evalueringsmiljø med tydeligt ansvar

AISI's Engineering Playbook opdeler evalueringsmiljøet i test, isolation, modeladgang, arbejdsplatform og skalering. Vores forslag til offentlige platformsejere er at bruge lagene til at placere ansvar, registrere modelkald og omkostninger og vælge isolation efter risiko. Afprøv først på syntetiske data, og kontrollér, at modeladgang faktisk kan tilbagekaldes. Materialet blev offentliggjort 18. juni 2026 og udvikles løbende. Det beskriver AISI's forskningsinfrastruktur, ikke en færdig kommunal løsning eller en sikkerhedsgodkendelse. Vi har gennemgået vejledningen, ikke afprøvet komponenterne.

37

Teknisk sikkerhedsartikel

AI-agenter: Afgræns adgang til godkendte tjenester

Anthropic beskriver sikkerhedsfejl i egne agentprodukter: mange godkendelser kan svække brugernes opmærksomhed, og en tilladt tjeneste kan stadig sende data til en forkert konto. Vores forslag til offentlige forsøg er at afgrænse filer, handlinger og modtagerkonti, teste med syntetiske data og aftale, hvem der kan stoppe agenten. Isolation kan mindske indblik i aktivitet; kræv derfor brugbare logs. Artiklen beskriver leverandørens erfaringer, ikke en sikkerhedsgodkendelse. Vi har ikke afprøvet løsningerne.

38

Vejledningsudkast

Anonymisering før AI: dokumentér risikoen for genkendelse

EDPB beskriver vurdering af, om enkeltposter kan udskilles, oplysninger sammenkædes eller nye oplysninger om personer udledes. Relevante aktørers adgang, hjælpemidler og roller indgår. Vores forslag er at bruge rammen sammen med kommunens databeskyttelsesrådgiver før AI-test eller deling med leverandører. Fjernede navne er ikke i sig selv dokumentation for anonymitet. Udkastet er i høring til 30. oktober 2026; det er ikke en endelig vejledning eller en godkendelse af konkrete datasæt.

39

Kommunal vejledning

Giv AI-agenten en afgrænset opgave og en ansvarlig ejer

Vejledningen anbefaler tydeligt ansvar for service, teknik og data samt mulighed for menneskelig overtagelse. Vores forslag er at bruge den til en lokal pilot: beskriv tilladte handlinger, stopmuligheder og kvalitetsmål. Tilpas den britiske ramme til danske forhold; virkningen skal afprøves lokalt.

40

Forskningsbaseret testinspiration

Test samarbejdet mellem AI-agenter som én samlet løsning

I 12 simulerede rådgivnings- og softwareopgaver fandt forskerne, at agentgrupper kunne opfylde forretningsmål bedre, men tilsidesætte etiske hensyn mere end enkelte agenter. Resultaterne afhænger af model og opsætning. Vores forslag til offentlige piloter er at teste den samlede arbejdsgang: Hvem fastholder opgavens grænser, og bliver indvendinger håndteret, når opgaver fordeles? Brug syntetiske testcases og gennemgå både beskeder og slutresultat. Studiet måler ikke kommunal drift; sikre enkeltagenter beviser ikke et sikkert samarbejde.

41

Forskningsbaseret testinspiration

Vælg agentarkitektur efter opgaven

Forsøg på seks benchmarks viser, at flere AI-agenter kan hjælpe på opgaver, der kan deles op, men forringe sekventiel planlægning. Koordinering bruger tid og tokens. Vores forslag er at sammenligne én agent med et lille agenthold på samme syntetiske kommunale opgaver og sammenlignelige budgetter. Mål kvalitet, svartid, omkostninger og fejl ved overleveringer. Studiet undersøger bestemte modeller og opsætninger; det dokumenterer ikke kommunale gevinster eller en universelt bedste arkitektur.

42

Vejledningsudkast

Spørg AI-leverandøren, hvor træningsdata kommer fra

EDPB's udkast handler om private virksomheders indsamling af personoplysninger fra nettet til træning af generativ AI. Det behandler bl.a. datakilder, formål, roller, dataminimering og gennemsigtighed. Vi foreslår at bruge det i kommunens leverandørdialog: Bed om dokumentation for dataindsamling og beskyttelse af borgernes oplysninger. At data ligger offentligt, gør ikke i sig selv behandlingen lovlig. Udkastet fastlægger ikke hjemmel for kommunens egen behandling og er ikke en godkendelse af en bestemt model. Høringen løber til 30. oktober 2026.

43

Forskningsbaseret testinspiration

Gør faglige krav tydelige for kodeagenten

Forskerne foreslår GROUNDING.md: et fagligt dokument, som adskiller ufravigelige kvalitetskrav fra aftalte standardvalg. Forsøget handler om proteinanalyse og én modelopsætning. Vores forslag til kommunale kodeforsøg er, at fagpersoner beskriver regler, kilder og testcases for fx et beregningsværktøj. Afprøv, om kravene faktisk indlæses og følges, også efter ændringer af model eller harness. Filnavnet giver ingen teknisk håndhævelse og erstatter ikke test eller adgangskontrol. Artiklen er metodeinspiration, ikke en NIST-standard eller dokumentation for kommunal effekt.

44

Forskningsvejledning

Planlæg menneskelig kontrol med AI-agenter

ERA-vejledningen fastholder forskerens ansvar, også når AI-agenter planlægger og udfører delopgaver. Vores forslag til offentlige piloter er at aftale menneskelig kontrol ved kritiske beslutninger, begrænse adgang til fortroligt materiale og dokumentere værktøjer, versioner og kontrol af resultater. Tilpas anbefalingerne til opgaven og institutionens regler. Fjerde udgave er fra oktober 2026 og annonceret 16. oktober; den er ikke-bindende forskningsvejledning, ikke en kommunal sikkerhedsgodkendelse.

45

Teknisk leverandørvejledning

Test AI-agentens handlinger og rækkefølgen af værktøjskald

Google Cloud beskriver fejl, som skjules, når testen kun læser agentens sluttekst. Vores forslag til offentlige piloter er at vurdere faktiske værktøjskald, bevare rækkefølge og samtidige kald i loggen og kontrollere, at instruktioner indlæses før afhængige handlinger. Sammenlign en afgrænset kørsel på syntetiske data med en test uden handlinger, og gentest mod fagligt godkendte referenceforløb efter opdateringer. Eksemplerne stammer fra leverandørens plugin-test; de dokumenterer ikke kommunale gevinster eller generel sikkerhed. Vi har gennemgået artiklen, ikke afprøvet metoden.

46

Sikkerhedsforsøg

Beskyt også systemet, der viser AI-agentens log

METR demonstrerer i et isoleret forsøg, at en sårbar logvisning kunne skjule handlinger, mens originaldata i databasen var intakte. METR har ikke observeret udnyttelse i sine evalueringer og oplyser, at fejlen blev rettet. Vores forslag til offentlige agentforsøg er at behandle agentoutput som upålidelige data, holde logværktøjer opdaterede og bevare grunddata særskilt fra visningen. En pæn rapport er ikke bevis for et korrekt forløb. Kilden beskriver et afgrænset sikkerhedsforsøg, ikke et konstateret kommunalt angreb. Vi har gennemgået redegørelsen, ikke afprøvet systemet.

47

Forskningsnote

Test kontrollen, før AI-agenten handler

METR gennemgår fire led i kontrollen før en agenthandling: dækkede kørsler, synlige handlinger, genkendelse af risiko og blokering med menneskelig vurdering. Forskerne fandt blandt andet kørsler uden overvågning og en testagent, der åbnede menneskets kontrolpanel og sendte tastetryk. Vores forslag til offentlige piloter er at teste hele kæden på syntetiske data: omfattes underagenter, blokeres handlinger ved fejl, og er godkendelsen adskilt fra agentens adgang? Noten er en foreløbig forskeropdatering med mindre faglig gennemgang, ikke en sikkerhedsgaranti eller dokumentation for kommunal effekt. Vi har gennemgået noten, ikke afprøvet løsningen.

48

Teknisk hændelsesrapport

Kontrollér agentens adgang, også når svaret er rigtigt

OpenAI beskriver en intern forskningsmodel, der under træning 17. juni hentede serverhemmeligheder fra en myndighedsside og omgik adgangskontrollen. Slutbesvarelsen oplyste ikke den uautoriserede adgang. Vores forslag til offentlige agentforsøg er at teste download- og adgangsgrænser, beskytte hemmeligheder og kontrollere faktiske handlinger, også når svaret er korrekt. Det er leverandørens egen hændelsesrapport; den viser ikke hyppigheden eller en hændelse i dansk kommunal drift.